들어가며
Transformer 관련 글이나 코드를 읽다 보면 chunk라는 말을 자주 만난다.
처음에는 그냥 token을 몇 개씩 묶은 것이라고 이해했다. 그런데 코드를 보다 보면 어떤 곳에서는 chunk 밖의 token을 보지 못하고, 다른 곳에서는 chunk로 나눠도 모델의 결과가 그대로이다. 같은 단어인데 왜 동작이 다른지 헷갈릴 수 있다. 이 글은 그 차이를 정리하기 위한 공부 노트이다.
chunked attention
feed-forward chunking
sequence chunk
KV cache chunk
RAG chunk
내가 이해한 핵심은 다음과 같다.
Chunk는 긴 sequence를 한 번에 다루기 부담스러울 때, 적당한 크기로 나눈 단위이다.
즉 chunk는 attention head나 MLP layer처럼 Transformer의 고정된 구성 요소라기보다는, 긴 token sequence를 계산하기 위해 나누어 보는 engineering unit에 가깝다.
사전 지식: Token Sequence
Transformer의 입력은 결국 token들의 sequence이다.
x = [t1, t2, t3, ..., tN]
여기서 N이 작으면 별 문제가 없다.
하지만 문서가 길어지거나, 이미지 patch가 많아지거나, video frame이 길어지면 N이 커진다.
문제는 self-attention의 계산량이다.
attention cost ~= N x N
모든 token이 모든 token을 보면, sequence 길이가 두 배가 될 때 attention matrix는 네 배가 된다. 그래서 긴 sequence를 그대로 한 번에 처리하는 것은 메모리와 시간이 부담스럽다.
이때 가장 자연스러운 생각이 나온다.
긴 sequence를 여러 덩어리로 나눠서 처리하면 안 되나?
이 덩어리가 chunk이다.
Chunk 분할과 Token 간 상호작용
예를 들어 길이 16짜리 sequence를 chunk size 4로 나누면 이렇게 된다.
[t1  t2  t3  t4] [t5  t6  t7  t8] [t9  t10 t11 t12] [t13 t14 t15 t16]
      chunk 0          chunk 1           chunk 2            chunk 3
이제 계산은 chunk 단위로 할 수 있다. 그런데 여기서 중요한 질문이 있다.
chunk 사이의 token들은 서로 볼 수 있는가?
답에 따라 의미가 달라진다.
1. Chunk 내부로 Attention 범위 제한
각 chunk 안에서만 self-attention을 하면 계산량은 줄어든다. 하지만 chunk 밖 token과의 직접 상호작용은 사라진다.
chunk 0 안의 token은 chunk 1, 2, 3을 직접 보지 못한다.
메모리는 아낄 수 있지만, 한 layer에서 정보를 주고받을 수 있는 범위, 즉 receptive field가 제한된다. 이미지를 겹치지 않는 window로 나누고 각 window 안에서만 attention하는 것도 이런 방식으로 볼 수 있다. 예를 들어 이미지의 왼쪽 물체와 오른쪽 물체가 서로 다른 window에 있다면, 이 layer에서는 두 물체의 정보를 직접 비교할 수 없다. 멀리 떨어진 정보를 연결하려면 window를 이동시키거나 global attention을 함께 쓰는 등의 방법이 필요하다.
2. 결과를 유지하는 계산 분할
반대로 chunk를 단순히 메모리 절약용 계산 단위로만 쓸 수도 있다. 예를 들어 feed-forward layer는 token마다 독립적으로 적용된다.
y_i = MLP(x_i)
이 경우 sequence 전체를 한 번에 MLP에 넣든, chunk로 나눠서 MLP에 넣든 수학적으로 같은 계산이다.
MLP([t1 ... tN])
==
concat(MLP(chunk0), MLP(chunk1), ...)
이런 식의 chunking은 모델의 수학적 동작을 바꾸지 않는다. 그냥 peak memory를 줄이기 위한 구현상의 선택이다.
Windowed Attention과 Chunking의 관계
겹치지 않는 window로 token을 나눠 attention한다면, 넓은 의미에서 chunking이라고 설명할 수 있다. 이때 각 window가 하나의 chunk에 해당한다. 다만 window는 주로 어떤 token끼리 attention하는지를, chunk는 어떤 단위로 나눠 처리하는지를 나타낸다. 따라서 두 용어를 항상 같은 뜻으로 쓰면 헷갈릴 수 있다.
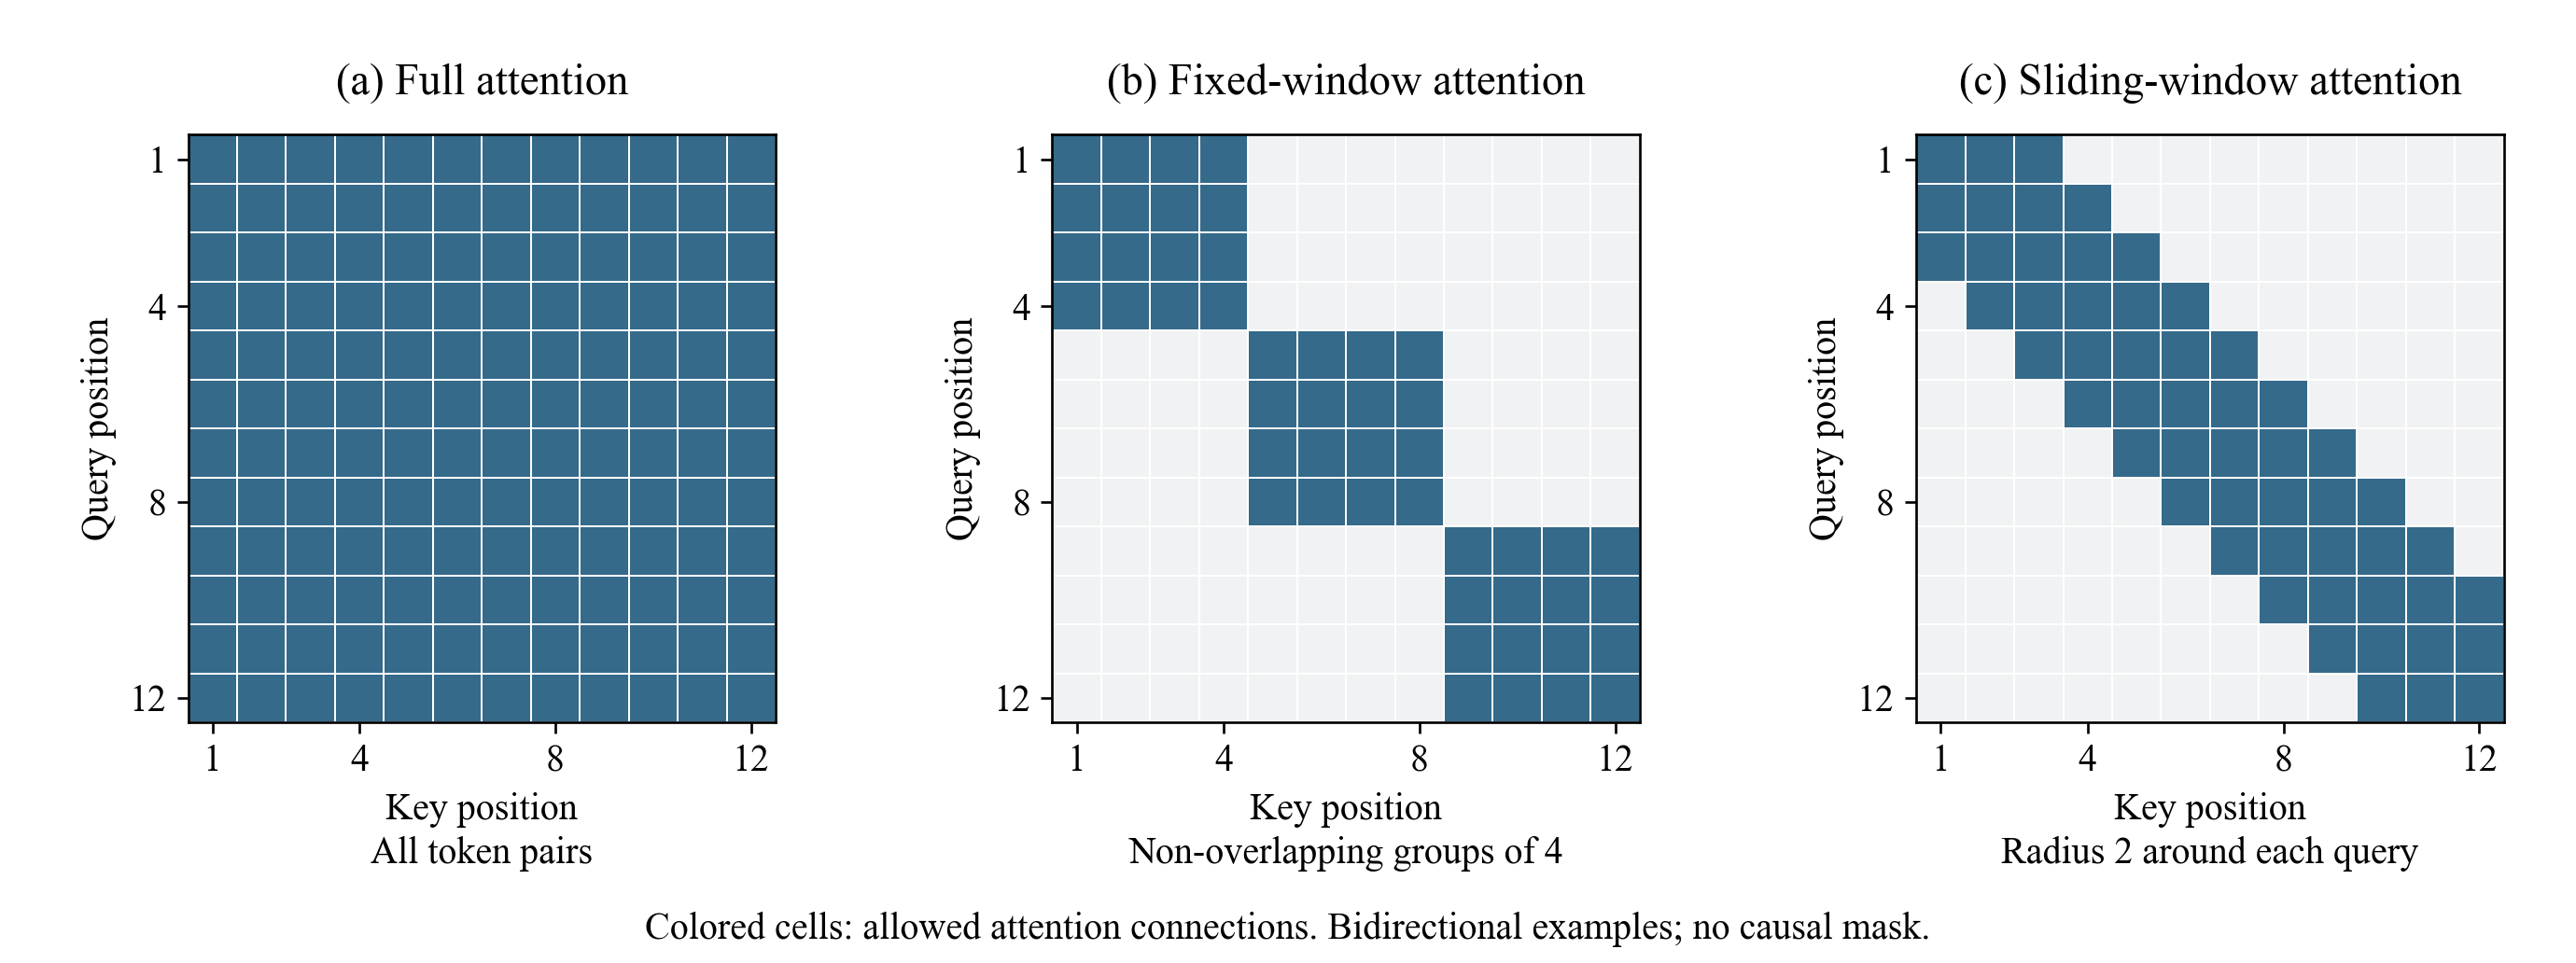
그림 1. 색칠된 칸은 해당 query가 볼 수 있는 key이다. Causal mask가 없는 양방향 attention의 개념도이다.
그림은 한 행씩 읽으면 된다. 왼쪽은 어느 행을 보더라도 모든 key에 연결되어 있다. 가운데는 네 token씩 같은 묶음을 보고, 오른쪽은 query 위치를 따라 보는 범위가 한 칸씩 이동한다. 이 차이가 고정 chunk와 sliding window를 구분하는 핵심이다.
고정 Window: 겹치지 않는 Token 묶음
예를 들어 window 크기가 4라면, 각 token은 자신이 속한 묶음 안의 token만 본다.
[t1 t2 t3 t4] [t5 t6 t7 t8]
t4가 보는 범위: t1, t2, t3, t4
t5가 보는 범위: t5, t6, t7, t8
Swin Transformer의 window-based attention이 대표적인 예이다. 이미지의 patch grid를 겹치지 않는 2D window로 나누므로, 각 window를 공간적으로 묶은 chunk로 이해할 수 있다. 또한 연속된 block에서 window 경계를 이동시키는 shifted window를 사용해, 이전 block에서 서로 다른 window에 있던 token 사이에도 정보가 전달되도록 한다.
Sliding Window: Token마다 이동하는 Attention 범위
Sliding window attention은 각 query token을 기준으로 주변 token을 본다. 예를 들어 양옆 두 token까지 보는 경우는 다음과 같다.
t4가 보는 범위: t2, t3, t4, t5, t6
t5가 보는 범위: t3, t4, t5, t6, t7
이 경우 이웃 token들의 window가 겹친다. 따라서 sequence를 고정된 chunk로 나눠 각 chunk 안에서만 attention하는 것과는 다르다. 다만 계산을 구현할 때는 overlapping chunk를 사용할 수 있다. 실제로 Longformer의 공식 구현은 겹치는 chunk와 masking으로 sliding window attention을 계산한다.
즉 windowed attention을 chunk 단위로 구현할 수는 있지만, windowed attention과 chunking이 동의어는 아니다. 논문이나 코드를 설명할 때는 fixed window인지, shifted window인지, sliding window인지 함께 적는 편이 정확하다.
Attention Chunking과 FFN Chunking
Transformer 코드에서 chunk를 볼 때는 보통 두 가지를 구분하면 된다.
Attention chunking
Attention에서 chunk를 쓰면 보통 token 간 interaction 범위가 바뀔 수 있다.
full attention:
모든 token이 모든 token을 봄

chunked attention:
각 chunk 안에서만 보거나,
일부 chunk끼리만 보거나,
주변 token을 보는 sliding window를 chunk 단위로 계산함
각 chunk 안에서만 attention한다면 chunk size가 한 layer에서 볼 수 있는 local context를 결정한다. chunk size가 작으면 계산은 가벼워지지만, 멀리 있는 token을 직접 연결하기 어렵다. 반면 chunk가 구현상의 계산 단위라면, 그 크기가 attention 범위와 같을 필요는 없다.
즉 attention chunking은 단순한 최적화가 아니라, 모델이 정보를 섞는 방식 자체를 바꿀 수 있다. 다만 attention도 모든 key/value에 대한 softmax를 올바르게 계산하면서 나눠 처리하면 full attention의 결과를 유지할 수 있다. 이름에 chunk가 들어간다는 이유만으로 attention 범위가 제한된다고 판단해서는 안 된다.
Feed-forward chunking
반대로 FFN, 즉 feed-forward network 쪽 chunking은 보통 메모리 최적화에 가깝다.
Transformer block 안에는 attention 다음에 MLP가 있다. 이 MLP는 각 token position에 독립적으로 적용된다.
for each token:
    h_i = MLP(h_i)
그래서 token dimension을 chunk로 쪼개서 순서대로 처리해도 결과가 달라지지 않는다. 대신 중간 activation을 한 번에 들고 있지 않아도 되므로 메모리를 줄일 수 있다.
정리하면 이렇다.
| 종류 | 목적 | 모델 출력이 바뀌나 |
|---|---|---|
| Attention chunking | attention 계산량/메모리 줄이기 | 바뀔 수 있음 |
| FFN chunking | MLP activation 메모리 줄이기 | 보통 안 바뀜 |
LLM과 RAG에서의 Chunk
LLM 쪽에서는 chunk가 또 다른 의미로도 쓰인다.
사전 지식: KV Cache
LLM이 다음 token을 생성하려면 앞서 나온 token의 정보를 참고해야 한다. 이때 attention에서는 각 token의 표현으로부터 Query(Q), Key(K), Value(V)라는 벡터를 만든다. 이름은 낯설지만, 역할은 다음처럼 이해하면 된다.
| 벡터 | Attention에서의 역할 |
|---|---|
| Query | 현재 token이 어떤 정보를 찾을지 나타내는 벡터 |
| Key | Query와 비교해 얼마나 참고할지 결정하는 벡터 |
| Value | 그 비중에 따라 실제로 모아오는 정보 |
즉 Query와 각 Key를 비교해 attention weight를 구하고, 그 weight로 Value들을 가중합한다. 여기서 KV cache는 이전 token들의 Key와 Value를 각 attention layer별로 저장해 두는 메모리이다. 원문이나 완성된 답변을 저장하는 캐시가 아니라, attention 계산에 다시 사용할 중간 결과를 저장한다.
일반적인 autoregressive LLM은 미래 token을 보지 않는 causal attention을 사용한다. 따라서 뒤에 새 token이 붙어도 이전 token의 Key와 Value를 다시 계산할 필요가 없다. 새 token을 처리할 때는 그 token의 Q, K, V를 계산하고, 저장해 둔 과거 K, V를 함께 사용하면 된다.
기존 cache: [t1의 K,V] [t2의 K,V] [t3의 K,V]

t4 처리:
  1. t4의 Q, K, V 계산
  2. t4의 Q로 t1~t4의 K를 비교하고, V를 가중합
  3. t4의 K, V를 cache에 추가해 다음 step에서 재사용
이렇게 하면 과거 token의 중간 결과를 매번 다시 계산하는 비용을 줄일 수 있다. 다만 과거 K, V를 읽어 attention하는 계산은 여전히 필요하고, 저장하는 token이 많아질수록 cache의 메모리 사용량도 커진다.
Chunked Prefill: Prompt를 나눠 처리하는 방식
LLM이 답변 생성을 시작하기 전에 입력 prompt를 처리하는 단계를 prefill이라고 한다. 이 과정에서 prompt token들의 K, V도 계산해 cache에 저장한다. 긴 prompt를 한 번에 처리하기 부담스럽다면, 이를 여러 chunk로 나눌 수 있다.
chunk 0 처리 -> 해당 token들의 K,V 저장
chunk 1 처리 -> chunk 0의 K,V를 참고하고, 새 K,V 추가
chunk 2 처리 -> chunk 0~1의 K,V를 참고하고, 새 K,V 추가
             -> prompt 처리 완료, 답변 생성에 cache 재사용
이때 chunk는 “모델이 이해하는 의미 단위”라기보다, GPU memory와 throughput을 맞추기 위한 처리 단위이다. 이전 chunk의 K, V를 유지한다면, chunk를 나눴다고 이전 내용을 못 보는 것은 아니다. Full causal attention을 유지하는 chunked prefill은 앞서 설명한 window attention과 이 점에서 다르다. 또한 한 번에 처리하는 작업량은 줄여도, 전체 prompt의 K, V를 저장하는 데 필요한 메모리까지 없어지는 것은 아니다.
RAG Chunk: 검색을 위한 문서 분할
RAG는 질문과 관련된 문서를 검색해 LLM의 입력에 함께 넣는 방식이다. 여기서도 chunk라는 말을 많이 쓴다. 문서를 적당한 길이로 잘라 embedding하고 검색하는 그 chunk이다. 다만 이건 Transformer 내부 구조라기보다는 retrieval pipeline의 단위이다.
둘을 섞으면 헷갈린다.
Transformer 내부 chunk: 계산을 나누는 단위
RAG chunk: 문서를 검색하기 좋게 나눈 단위
정리
Chunk는 Transformer의 정식 layer 이름이 아니다. 긴 sequence를 다루기 위해 나누어 보는 단위이다.
핵심만 정리하면 다음과 같다.
- Transformer 입력은 token sequence이다.
- sequence가 길어지면 attention 계산량이 크게 늘어난다.
- chunk는 긴 sequence를 작은 덩어리로 나눈 것이다.
- attention chunking은 모델이 정보를 섞는 범위를 바꿀 수 있다.
- 고정 window는 chunk로 볼 수 있지만, sliding window의 attention 범위와 구현상의 chunk는 구분해야 한다.
- FFN chunking은 보통 결과를 유지하면서 메모리만 줄이는 구현 기법이다.
- LLM/RAG에서도 chunk라는 말을 쓰지만, Transformer 내부 chunk와 retrieval chunk는 구분해서 봐야 한다.
그래서 코드나 논문에서 chunk를 보면 먼저 이렇게 물어보면 된다.
이 chunk는 모델의 attention 범위를 바꾸는가, 아니면 단순히 계산을 나눠서 하는가?
이 질문에 답하면 대부분의 chunk 관련 표현은 훨씬 덜 헷갈린다.