들어가며
Vision Transformer 글을 읽다 보면 register token이라는 말이 나온다.
처음 보면 [CLS] token처럼 무언가를 대표하는 token인가 싶다.
그런데 register token은 마지막 output을 직접 쓰지도 않는다고 한다.
그렇다면 쓰지도 않을 token을 왜 넣는 것일까?
이 질문에서 출발하면 register token의 역할이 조금 더 자연스럽게 보인다.
내가 이해한 결론부터 말하면 이렇다.
Register token은 모델이 내부 계산에 쓸 수 있도록 따로 넣어주는 scratch space이다.
이미지 자체를 나타내는 patch token도 아니고,
최종 classification에 쓰는 [CLS] token도 아니다.
Transformer가 forward pass 중간에 정보를 모으고 다시 전달할 수 있도록 마련한 자리라고 보면 된다.
다만 ‘빈 공간’이라는 비유가 초기값이 0이라는 뜻은 아니다.
입력에 붙이는 embedding 자체도 학습되는 parameter이다.
이 아이디어를 잘 보여준 논문이 ICLR 2024의 Vision Transformers Need Registers이다. 이 글은 그 논문을 기준으로 register token을 정리한다.
문제: Feature Map의 Artifact
ViT는 이미지를 patch로 자르고, 각 patch를 token으로 바꾼다.
image
  -> patch tokens
  -> Transformer
  -> feature map
이 feature map은 downstream task에서 중요하다. 예를 들어 segmentation, depth estimation, object discovery처럼 위치별 정보가 필요한 task에서는 patch token 하나하나의 feature가 깔끔해야 한다.
그런데 Vision Transformers Need Registers 논문은 여러 ViT 모델에서 이상한 현상을 관찰한다.
일부 patch token의 norm이 비정상적으로 커진다.
attention map이나 feature map에 튀는 artifact가 생긴다.
논문에서는 이런 token을 high-norm token 또는 outlier token으로 본다. DINOv2 같은 큰 모델에서 특히 눈에 띄고, supervised model인 DeiT-III나 OpenCLIP에서도 비슷한 현상이 보인다.
중요한 점은 이 outlier token들이 주로 이미지의 중요한 object 영역이 아니라, 정보량이 적은 background 쪽에서 나타난다는 것이다.
원인 해석: Background Token의 재활용
논문의 해석은 꽤 흥미롭다.
모델이 보기에 어떤 patch는 별로 중요하지 않다. 예를 들어 하늘, 벽, 흐릿한 배경처럼 주변 patch와 거의 비슷한 곳이다.
이런 patch token은 원래 local information을 담아야 한다. 하지만 모델 입장에서는 그 patch의 세부 정보를 굳이 보존하지 않아도 전체 image representation에 큰 손해가 없을 수 있다.
논문은 모델이 이런 token을 다른 용도로 재활용하는 것으로 해석한다.
정보량이 적은 background patch token
  -> local patch 정보를 버림
  -> global image 정보를 저장하는 내부 계산용 token처럼 사용됨
논문은 outlier token들이 원래 patch의 위치나 픽셀 정보를 덜 담고, 대신 image-level 정보를 더 담는 경향이 있다고 분석한다.
즉 모델이 background patch token을 일종의 임시 메모리처럼 쓰고 있는 것이다. 문제는 이 token들이 여전히 feature map의 일부라는 점이다.
segmentation이나 object discovery처럼 patch-level feature가 중요한 task에서는, 이런 재활용이 feature map을 지저분하게 만든다.
해결: Register Token을 통한 작업 공간 확보
Register token의 아이디어는 단순하다.
모델이 어차피 내부 계산용 token을 필요로 한다면, background patch를 몰래 재활용하게 두지 말고, 처음부터 그런 용도의 token을 따로 주자는 것이다.
구조는 대략 이렇게 된다.
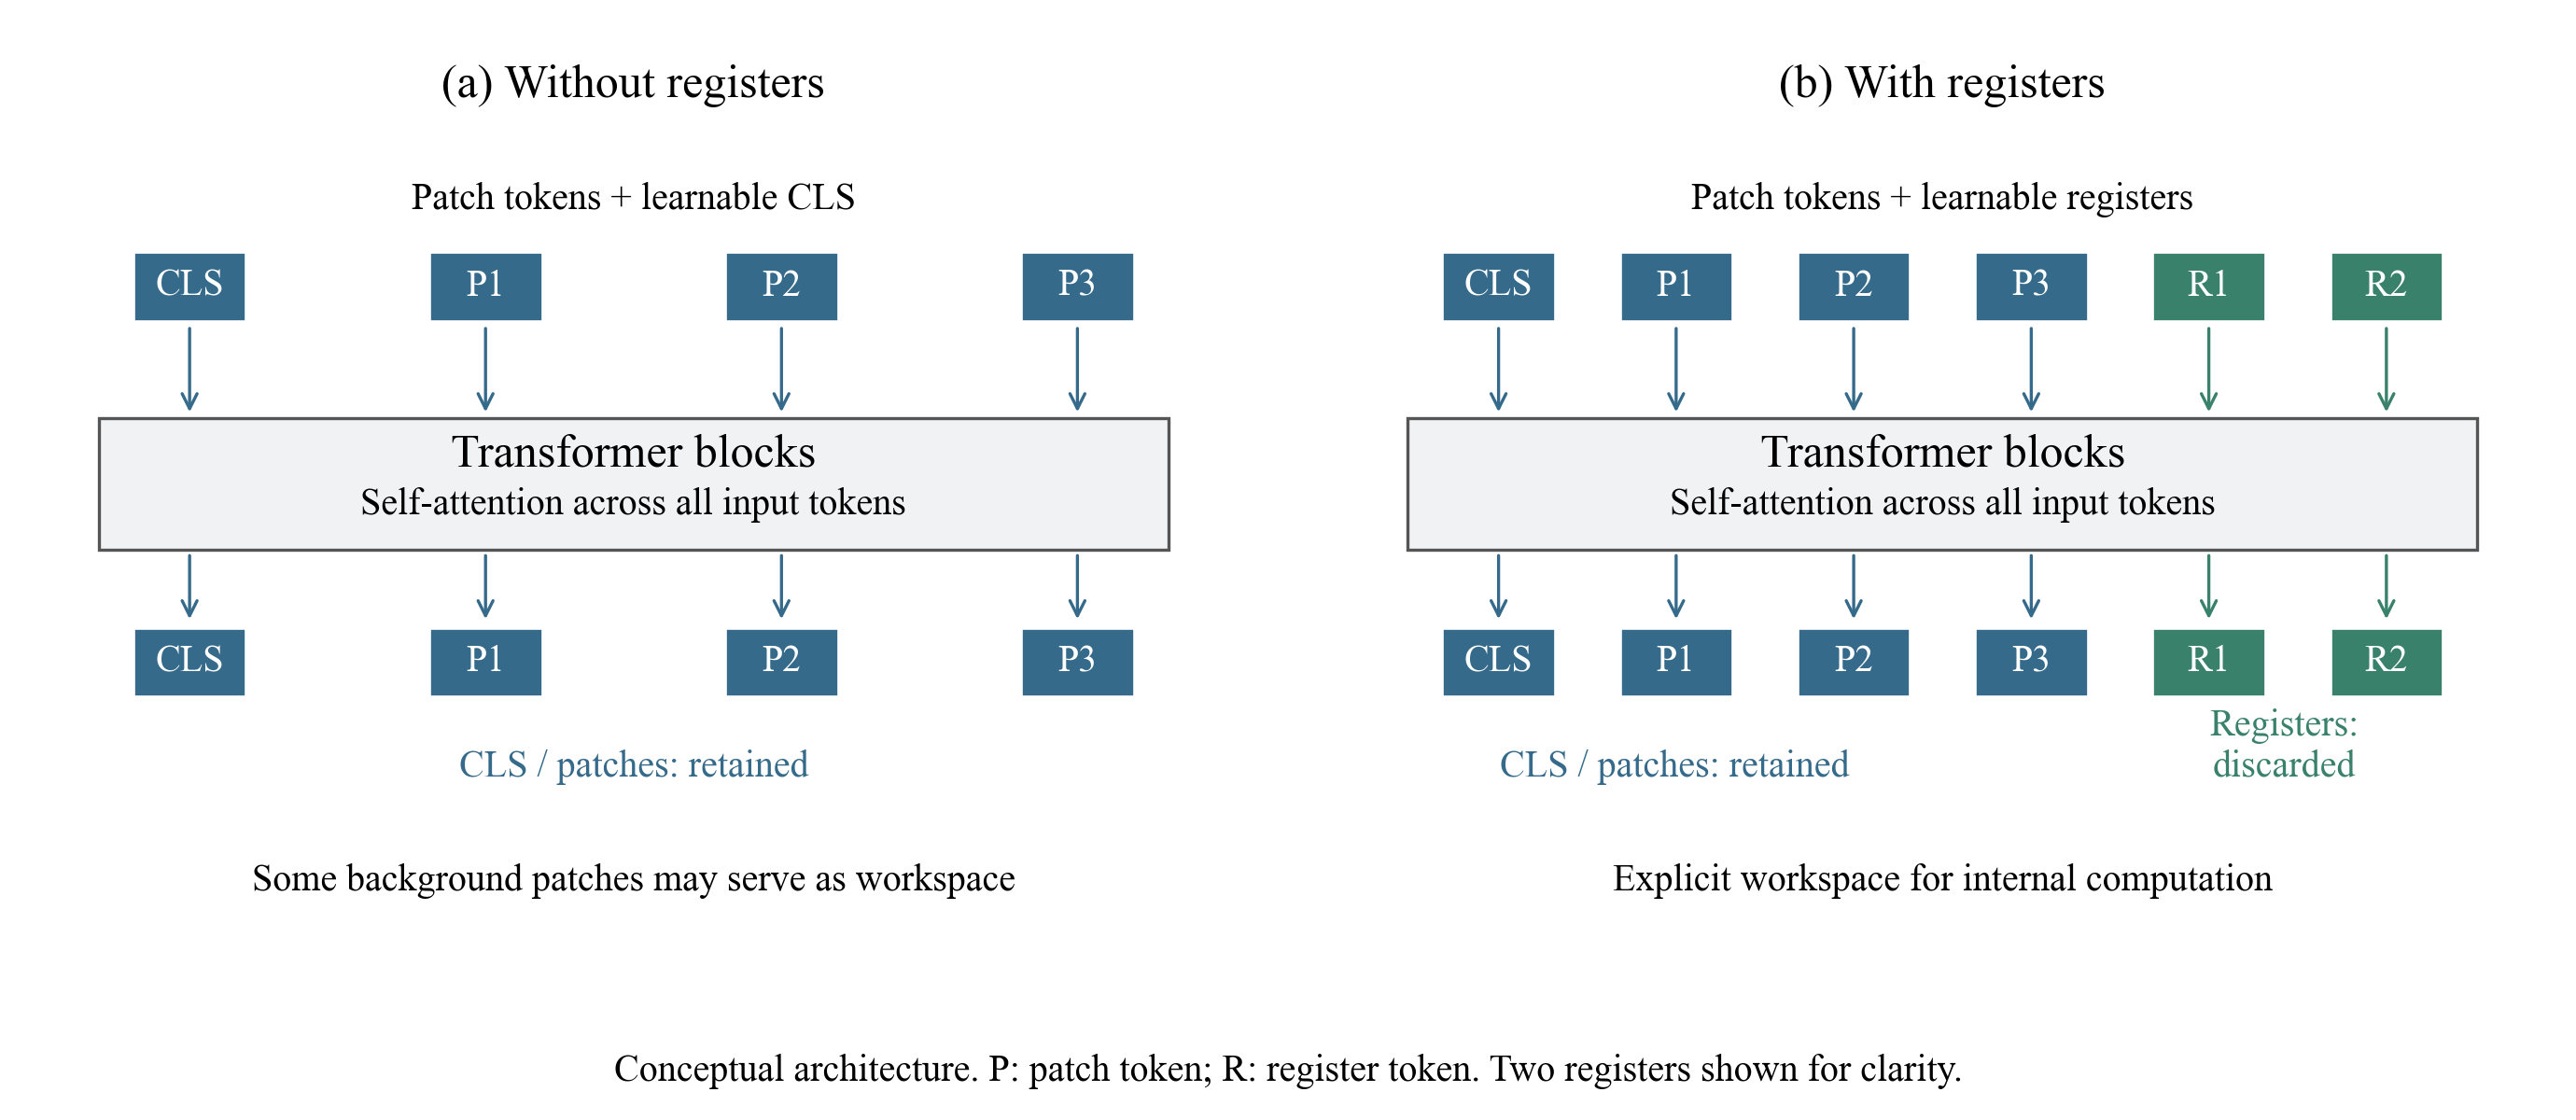
그림 1. Register token을 추가한 ViT의 개념도. P는 patch token, R은 register token이다. 설명을 위해 register 두 개만 표시했으며, token의 표시 순서는 역할을 구분하기 위한 것이다.
그림에서 중요한 부분은 오른쪽의 초록색 token이다. 이 token도 patch token과 함께 Transformer block을 지나며 정보를 주고받는다. 그러나 마지막에는 CLS와 patch의 output만 사용하고 register의 output은 제외한다. 즉 계산 과정에는 참여하지만, 최종 결과로 직접 읽지는 않는 자리이다.
여기서 [reg] token들은 learnable token이다.
입력 이미지에서 온 정보가 아니라, [CLS] token처럼 학습되는 parameter로 시작한다.
Transformer layer를 지나면서 이 token들은 다른 patch token들과 attention으로 상호작용한다. 하지만 마지막 output으로는 보통 버린다.
최종 representation:
[CLS]와 patch token은 사용
register token은 discard
즉 register token은 최종 예측을 직접 담당하는 token이 아니다. 모델이 중간 계산을 할 수 있는 여분의 workspace이다.
[CLS] Token과의 역할 차이
[CLS] token도 special token이고, register token도 special token이다.
그래서 둘이 헷갈릴 수 있다.
차이는 output을 어떻게 쓰느냐에 있다.
| Token | 역할 | 최종 output에서 사용하나 |
|---|---|---|
| Patch token | 이미지의 local region 표현 | dense task에서 사용 |
[CLS] token |
image-level representation 집약 | classification 등에 사용 |
| Register token | 내부 계산용 workspace | 보통 버림 |
[CLS] token은 결과를 모으기 위한 대표 token이다.
반면 register token은 결과로 쓰기보다,
중간 계산 중에 정보를 잠깐 저장하고 꺼내 쓰는 공간에 가깝다.
논문에서도 register token은 새 정보를 주입하지 않고,
그 output value도 직접 쓰지 않는다고 설명한다.
이 점이 [SEP], [MASK], object query, latent token 같은 다른 special token들과 다르다.
효과: Artifact 감소와 Dense Task 성능 개선
Register token을 넣으면 모델은 background patch token을 억지로 내부 계산용 메모리로 바꿔 쓸 필요가 줄어든다.
before:
background patch token이 scratch space 역할까지 떠맡음

after:
register token이 scratch space 역할을 맡음
patch token은 local feature 역할에 더 집중
논문에서는 register token을 넣으면 high-norm outlier token이 사라지고, feature map과 attention map이 더 smooth해진다고 보고한다.
또한 dense prediction task나 object discovery에서 성능이 좋아진다. 예를 들어 DINOv2에 register를 넣은 경우, 논문 실험에서 ADE20k segmentation과 NYUd depth estimation 성능이 개선되고, LOST 기반 object discovery에서도 큰 폭의 개선이 나타난다.
흥미로운 점은 register token이 꼭 많이 필요한 것은 아니라는 점이다. 논문은 register token 수를 바꿔보며 실험했고, visible artifact를 없애는 데는 하나만으로도 충분한 경우가 있지만, 실험에서는 보통 4개 register token을 사용했다.
Perception 관점: 위치별 Feature와 작업 공간
Perception 관점에서는 patch token이 이미지의 특정 위치에 대응한다는 점이 중요하다. 예를 들어 segmentation에서는 그 위치가 물체인지 배경인지 판단해야 하므로, 해당 patch의 local information이 output feature에 남아 있기를 기대한다.
patch token은 원래 각 patch의 정보를 담아야 하는 자리이다. 그런데 모델이 계산하다 보면 전체 이미지에 대한 요약 정보나 중간 계산 결과를 잠깐 둘 공간이 필요할 수 있다.
공간이 따로 없으면 모델은 별로 중요하지 않은 background patch token을 빌려 쓴다. 이러면 계산은 되지만, feature map에는 이상한 얼룩이 남는다.
이때 register token을 주는 것은 다음처럼 이해할 수 있다.
배경 token을 몰래 작업 메모리로 쓰지 말고,
처음부터 작업용 메모리 token을 따로 줄게.
다만 register가 들어갔다고 patch token에는 local information만, register에는 global information만 담기도록 강제하는 것은 아니다. 모든 token은 attention으로 상호작용한다. 논문의 관찰은 여분의 작업 공간을 제공했을 때 patch feature의 artifact가 줄어든다는 것이다.
정리
Register token은 ViT 입력 sequence에 추가하는 learnable token이다. 이미지 patch에서 온 token은 아니고, 최종 output으로 직접 쓰지도 않는다.
핵심만 정리하면 다음과 같다.
- 큰 ViT에서는 일부 patch token이 high-norm outlier가 되며 feature map artifact를 만들 수 있다.
- 이 outlier는 주로 정보량이 적은 background patch에서 나타난다.
- 논문의 해석은 모델이 그런 patch token을 내부 계산용 memory처럼 재활용한다는 것이다.
- Register token은 이 내부 계산용 공간을 명시적으로 제공한다.
- 그러면 patch token은 local feature 역할에 더 집중하고, feature/attention map이 더 깔끔해진다.
[CLS] token은 output representation으로 쓰지만, register token은 보통 마지막에 버린다.
한 줄로 정리하면 이렇다.
Register token은 ViT가 위치별 patch feature를 유지하면서 내부 계산에 활용할 수 있도록 추가한 작업 공간이다.