Introduction
Attention은 어느 token에서 정보를 가져올지 결정한다. 그런데 가져온 정보를 매번 같은 방식으로 다음 단계에 전달해야 할까? 현재 token에 별로 필요하지 않은 정보라면 전달량을 줄일 수 있지 않을까?
Gated Attention은 이런 관점에서 이해할 수 있다.
Attention output에 입력 의존적인 gate를 곱해, 모아온 정보를 얼마나 전달할지 조절한다.
여기서는 2025년 논문의 SDPA output gating과 이를 채택한 Qwen 계열을 기준으로 설명한다. Gated attention이라는 표현이 붙은 모든 연구가 같은 구조를 쓰는 것은 아니다.
구조: Attention 다음의 Gate
SDPA는 scaled dot-product attention이다. Q와 K의 비교에 softmax를 적용하고, 그 weight로 V를 가중합하는 익숙한 attention을 뜻한다. 설명을 단순화하면 output gating은 다음과 같다.
\[U=\mathrm{Attention}(Q,K,V),\qquad G=\sigma(XW_g)\] \[Y=(U\odot G)W_o\]\(X\)는 projection에 들어가는 hidden state, \(W_g\)는 gate projection, \(W_o\)는 output projection이다. \(\sigma\)는 sigmoid이므로 gate 값은 0~1 사이이다.
X -> Q,K,V -> Attention output U --+
X -> Gate projection -> sigmoid --+-> 성분별 곱 -> Output projection
Head별 elementwise gate라면 U와 G는 모두 [B, N, H, d_h]로 볼 수 있다.
각 token, head, channel에서 전달량을 다르게 조절한다.
(Gated Attention, NeurIPS 2025)
Attention Weight와 Gate의 차이
Attention weight는 어디에서 정보를 가져올지 결정한다. Gate는 모아온 결과를 얼마나 전달할지 결정한다. 위치는 다르지만 둘은 함께 학습되므로 서로 영향을 준다.
논문은 특정 token, 특히 첫 token에 큰 attention이 몰리는 attention sink 현상도 분석한다. SDPA output gating이 실험에서 이 현상과 큰 activation을 줄였다고 보고한다. 다만 softmax 합이 1이라는 성질 하나로 모든 sink를 설명할 수는 없고, 모든 집중된 attention이 오류인 것도 아니다. (논문의 분석)
Gate가 작아졌다고 그 앞의 attention 계산을 생략한 것은 아니다. 따라서 이 방식만으로 full attention의 계산 복잡도가 줄어들거나, sparse kernel의 속도 이득이 자동으로 생기지는 않는다.
실제 채택: Qwen3-Next와 Qwen3.5
Qwen3-Next는 Gated DeltaNet과 Gated Attention을 섞은 hybrid 구조를 사용한다. Qwen3.5-35B-A3B model card에도 같은 계열의 구성이 명시되어 있다. (Qwen3-Next 공식 model card, Qwen3.5 공식 model card)
두 이름은 구분해야 한다. Gated Attention은 여기서 설명한 softmax attention의 output gating이고, Gated DeltaNet은 recurrent state를 갱신하는 별도의 linear attention 계열이다. Model card에서 둘을 함께 사용한다고 해서, sigmoid 하나를 추가하면 전체 hybrid 구조의 효율을 얻는 것은 아니다.
즉 최근 공개 LLM에 실제로 채택된 설계라는 근거는 있다. 그러나 이 사실만으로 일반 ViT에서도 널리 검증된 표준이라고 말할 수는 없다.
SwiGLU와 LayerScale의 차이
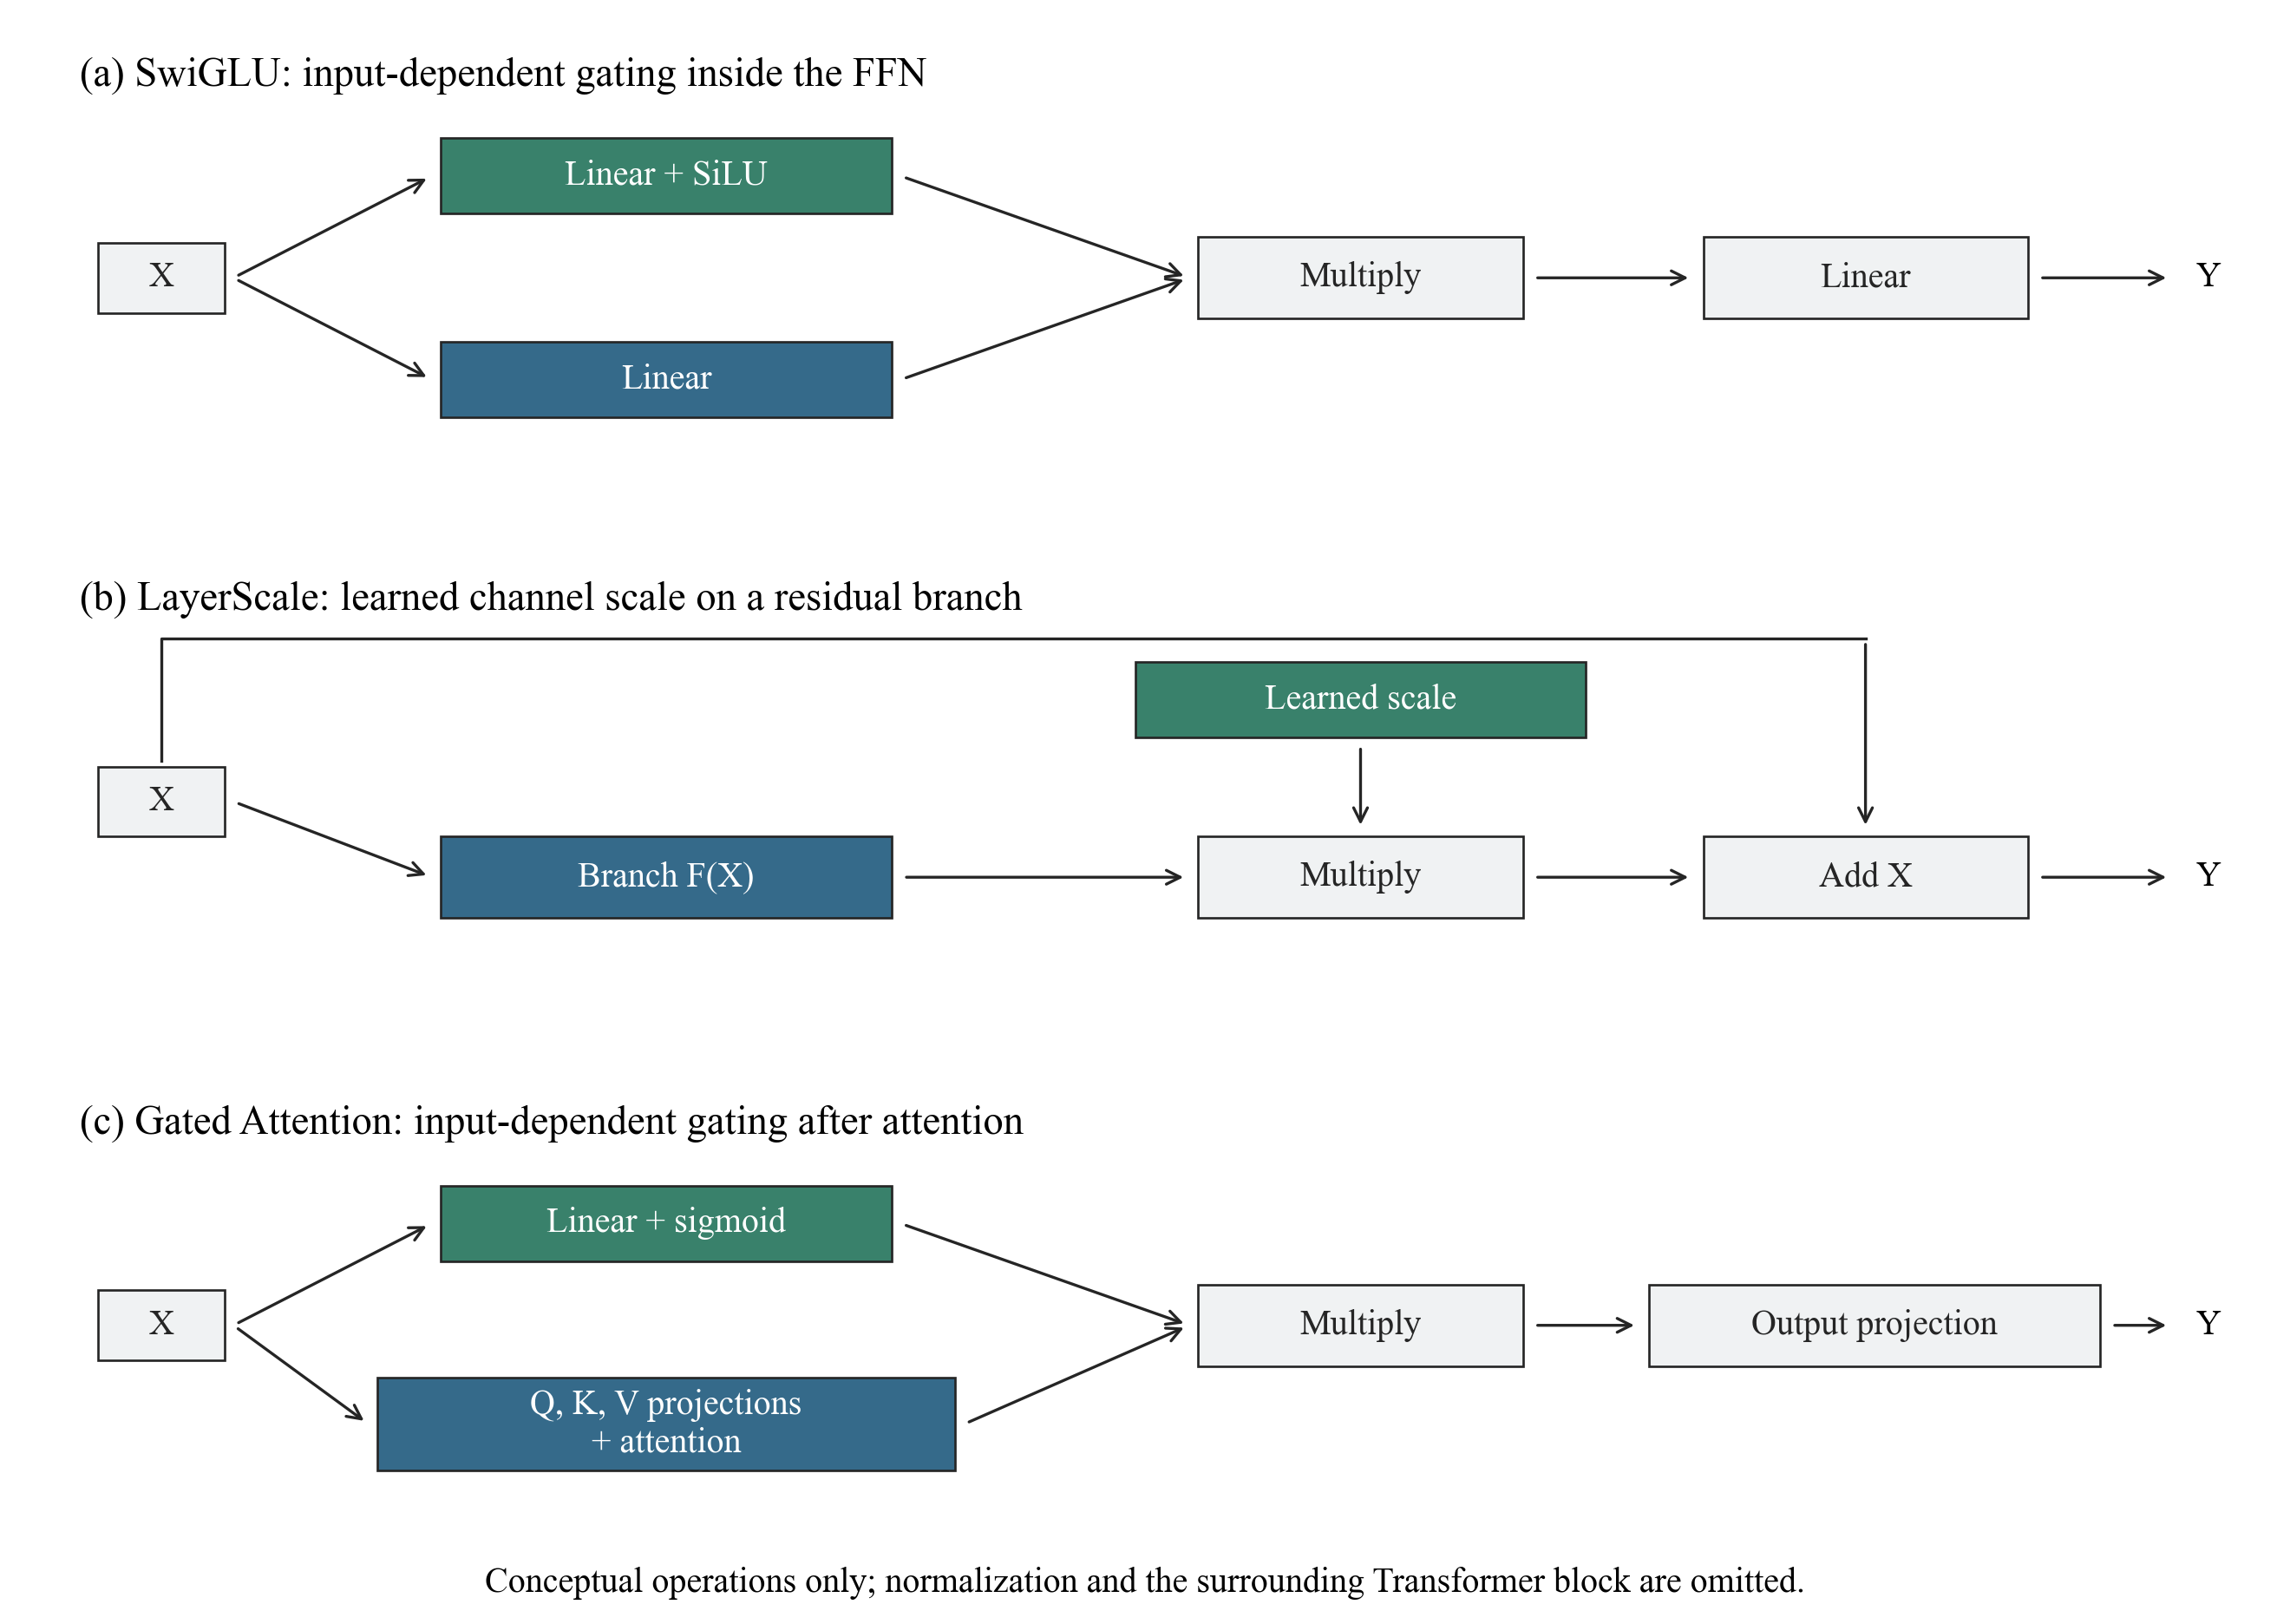
그림 1. 각 기법의 핵심 연산만 표시한 개념도. 전체 Transformer block과 모든 normalization은 생략했다.
| 기법 | 조절 대상 | 입력마다 달라지는가 |
|---|---|---|
| SwiGLU | FFN 내부의 feature | 예, SiLU branch로 조절 |
| LayerScale | Residual branch 출력 | 아니오, 학습된 channel별 scale 공유 |
| Gated Attention | Attention이 모아온 output | 예, 현재 입력으로 sigmoid gate 계산 |
세 방법 모두 곱셈이 들어가지만 같은 것을 대체하는 부품은 아니다. 특히 SwiGLU의 SiLU 값은 sigmoid처럼 0~1로 제한되지 않는다.
Vision 적용: 검증할 가설
ViT에서도 token마다 필요한 context가 다르므로, output gating을 실험할 이유는 있다. 다만 아래는 LLM의 결과로부터 가져온 연구 가설이며, vision 성능 개선이 확인되었다는 주장은 아니다.
예를 들어 배경 token에서 불필요한 global context 전달이 줄어드는지, 작은 물체의 patch에서는 필요한 정보가 유지되는지 볼 수 있다. CLS에 attention이 몰리는 것만으로 sink라고 판단하면 안 된다. CLS는 원래 global representation을 읽는 역할이 있기 때문이다.
Pretrained ViT에 gate를 추가한다면 초기 output이 어떻게 달라지는지도 중요하다. Gate logit을 0으로 초기화하면 sigmoid는 0.5이므로, attention output을 절반으로 줄인다. 이는 기존 함수를 보존하는 초기화가 아니다.
따라서 처음부터 학습하는 비교와 pretrained 구조를 수정하는 비교를 나누고, parameter 증가량, 학습 조건, dense prediction metric을 맞춰 평가해야 한다. Register token과도 역할이 다르므로 별도 ablation이 필요하다.
정리
Gated Attention은 다른 token에서 모아온 정보를 현재 입력에 맞게 조절하는 장치이다. 최근 LLM의 채택 사례가 있고, vision으로 가져와 볼 만한 아이디어이다. 다만 QK-Norm이나 2D RoPE처럼 이미 vision 채택 근거가 있는 기법과는 구분해 실험하는 것이 좋다.