Introduction
LLM 설정을 보면 Query head는 32개인데 Key/Value head는 8개인 경우가 있다. Q, K, V는 항상 같은 수의 head로 나누는 것 아니었을까?
이 차이를 만드는 대표적인 방식이 GQA(Grouped-Query Attention)이다.
GQA는 여러 Query head가 하나의 Key/Value head를 공유하도록 만든 attention이다.
최근 LLM에서 자주 보이지만, vision에 가져오려면 무엇을 절약하는 방법인지 먼저 알아야 한다.
사전 지식: Head와 KV Cache
Attention head는 token 간 정보를 서로 다른 projection으로 비교하고 모으는 단위이다. Q는 비교를 요청하는 벡터, K는 비교 대상, V는 실제로 가져올 정보라고 이해하면 된다.
Autoregressive LLM은 새 token을 처리할 때 과거 token의 K와 V를 재사용한다. 이를 저장해 두는 것이 KV cache이다. Context가 길수록, K/V head가 많을수록 cache의 저장량과 읽기 비용이 커진다.
MHA, MQA, GQA의 차이
| 방식 | Query head | K/V head |
|---|---|---|
| MHA: Multi-Head Attention | 여러 개 | Query head마다 별도 K/V |
| MQA: Multi-Query Attention | 여러 개 | 전체 Query가 한 K/V 공유 |
| GQA: Grouped-Query Attention | 여러 개 | Query group마다 한 K/V 공유 |
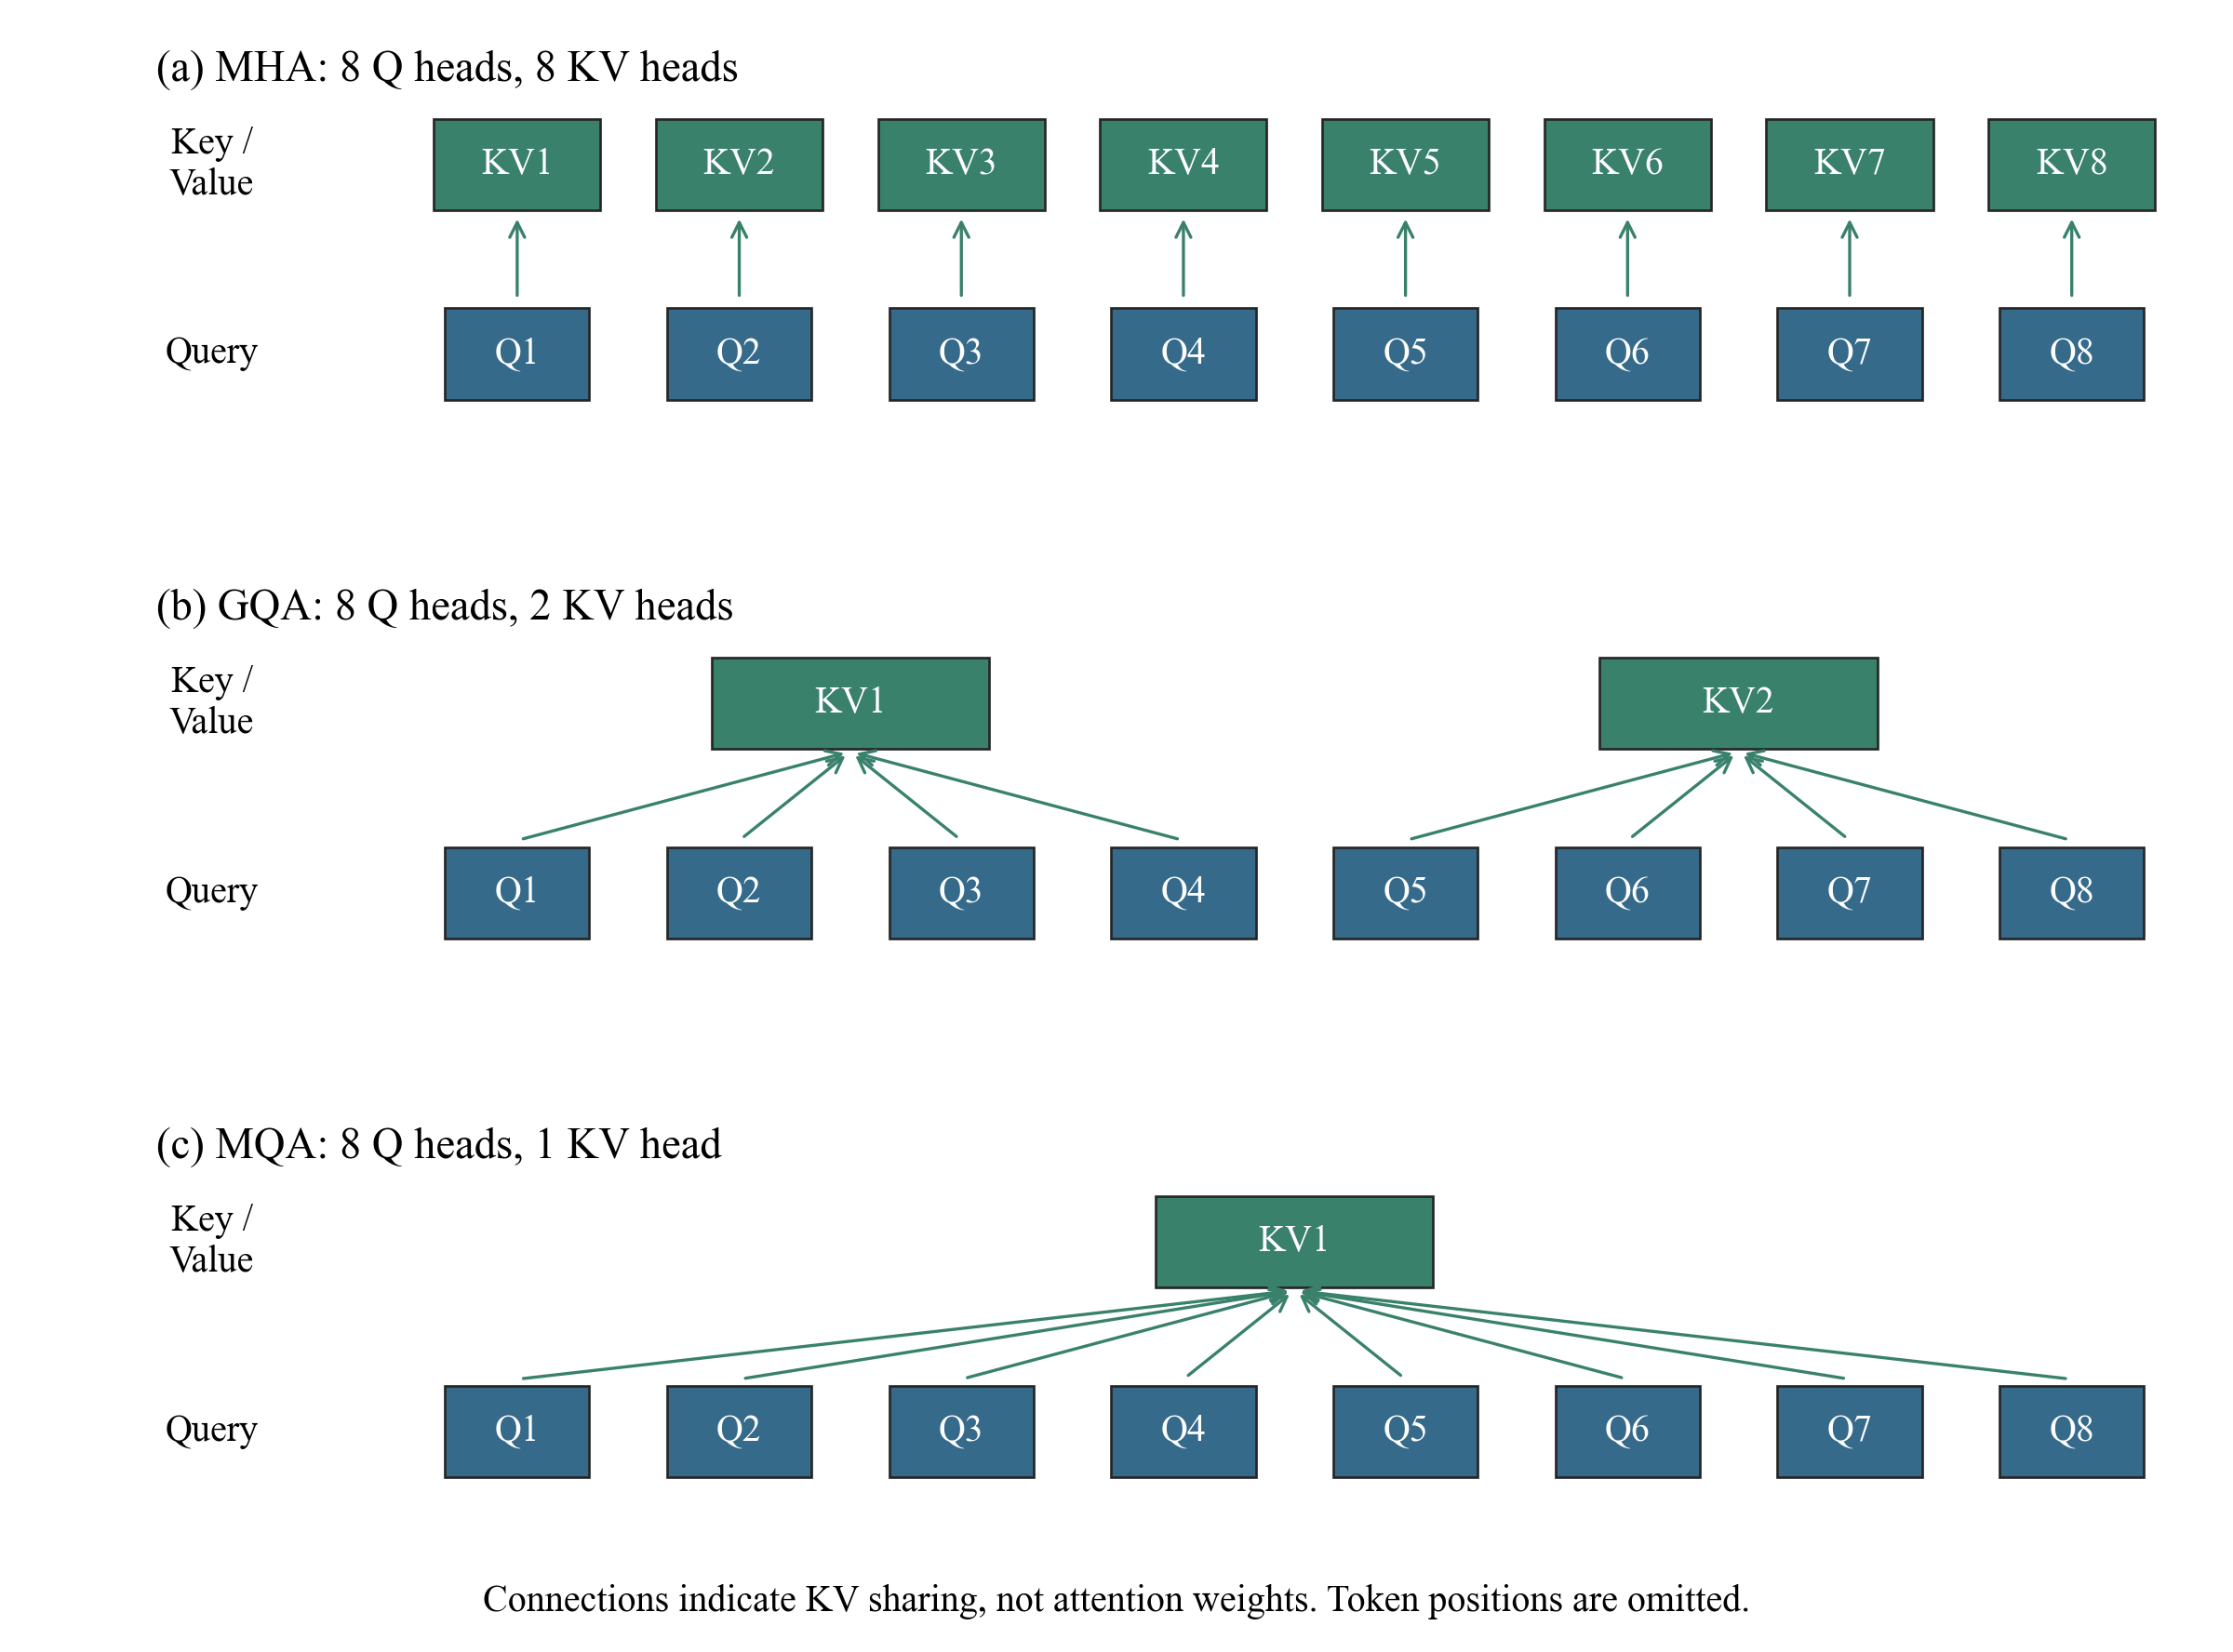
그림 1. 사각형 하나는 하나의 K/V head 쌍이다. 선은 각 Query가 어느 K/V를 사용하는지 나타낸다. 실제 attention weight의 시각화는 아니다.
GQA에서 같은 K/V를 사용하는 Query끼리도 attention weight가 같을 필요는 없다. Query 벡터가 서로 다르므로, 같은 정보에서 서로 다른 부분을 선택할 수 있다. 줄어드는 것은 K/V projection의 독립성이다. (GQA, EMNLP 2023)
Shape 예시: Query 32개와 KV 8개
Head dimension이 128이고 Query head가 32개, K/V head가 8개라고 하자. 아래는 원리를 설명하기 위한 예시이다.
Q: [B, 32, N, 128]
K: [B,  8, N, 128]
V: [B,  8, N, 128]

Query head 4개가 K/V head 한 쌍을 공유
같은 context 길이, layer 수, 정밀도라면 cache의 K/V 데이터 양은 일반적으로 K/V head 수에 비례한다. 이 예시에서 32개 K/V head를 쓰는 MHA 대비 K/V 저장량은 1/4이다. 이는 모델 전체 메모리나 총 실행 시간이 1/4이 된다는 뜻은 아니다. FFN, model weight, 다른 activation과 kernel 효율도 영향을 준다.
Query 수가 그대로이므로 GQA가 full attention의 token 간 비교를 선형 복잡도로 바꾸는 것도 아니다. 또한 K/V를 실제로 반복 복사하는 구현에서는 기대한 메모리 절감이 줄어들 수 있다.
실제 채택: Qwen3
Qwen3의 architecture 표에는 Query/KV head 수가 따로 나온다. 예를 들어 Qwen3-8B는 32/8 구성을 사용한다. 이는 GQA가 논문상의 아이디어에 머물지 않고 배포되는 LLM의 기본 설계에 포함된 사례이다.
원 논문은 기존 MHA checkpoint를 GQA로 전환하고 추가 학습하는 방법도 다룬다. 전환이 가능하다는 것과, head를 합친 직후 같은 성능이 유지된다는 것은 다르다.
ViT 적용: KV Cache가 없는 경우
일반적인 image encoder는 이미지를 한 번 처리하고 feature를 반환한다. LLM처럼 다음 token 생성을 위해 긴 KV cache를 계속 유지하지 않는다. 따라서 LLM에서 얻은 큰 cache 절감 효과가 그대로 나오지는 않는다.
K/V projection parameter와 중간 tensor는 줄일 수 있지만, attention과 FFN 중 어디가 실제 병목인지부터 확인해야 한다. 특히 dense prediction에서는 K/V 표현의 다양성이 줄어드는 것이 성능에 어떤 영향을 주는지도 평가해야 한다.
Streaming video나 과거 visual token을 cache하는 구조라면 GQA의 목적과 더 잘 맞을 수 있다. 이 역시 해당 시스템이 실제로 K/V를 저장하고 재사용하는 경우에 대한 설계 제안이다.
정리
GQA는 여러 방식으로 질문하되, 참고할 K/V 표현은 묶어서 공유하는 방법이다. LLM에서의 주된 매력은 inference 효율이다. ViT에서는 정확도 개선 기법으로 가정하기보다, 품질과 비용의 trade-off를 측정하는 실험으로 접근하는 편이 맞다.